Comment l'IA peut-elle améliorer la qualité des contrôles au Middle Office ?
En passant d'un contrôle par échantillon à un contrôle exhaustif, où l'humain ne traite plus que les exceptions. L'IA ne valide rien : elle hiérarchise, et c'est précisément ce qui manque aux équipes.
Trois apports concrets. La détection d'abord : variations aberrantes d'un trimestre à l'autre, ruptures de cohérence entre sources, champs incomplets, sur la totalité des lignes et non sur un échantillon. L'explication ensuite : chaque alerte doit être motivée, avec la règle déclenchée et les valeurs en cause, faute de quoi l'équipe cesse de lire les alertes. La traçabilité enfin : qui a levé l'exception, sur quel fondement, avec quelle pièce justificative, pour que le régulateur comme le valorisateur retrouvent le fil.
Le module Middle Office de Bodic Apps applique cette logique sur des données partagées avec le reste de la plateforme, ce qui évite les contrôles de cohérence entre outils. La définition du plan de contrôle lui-même, seuils, priorités et responsabilités, relève du cadrage mené avec Bodic Conseil.
Peut-on automatiser efficacement le reporting des participations ?
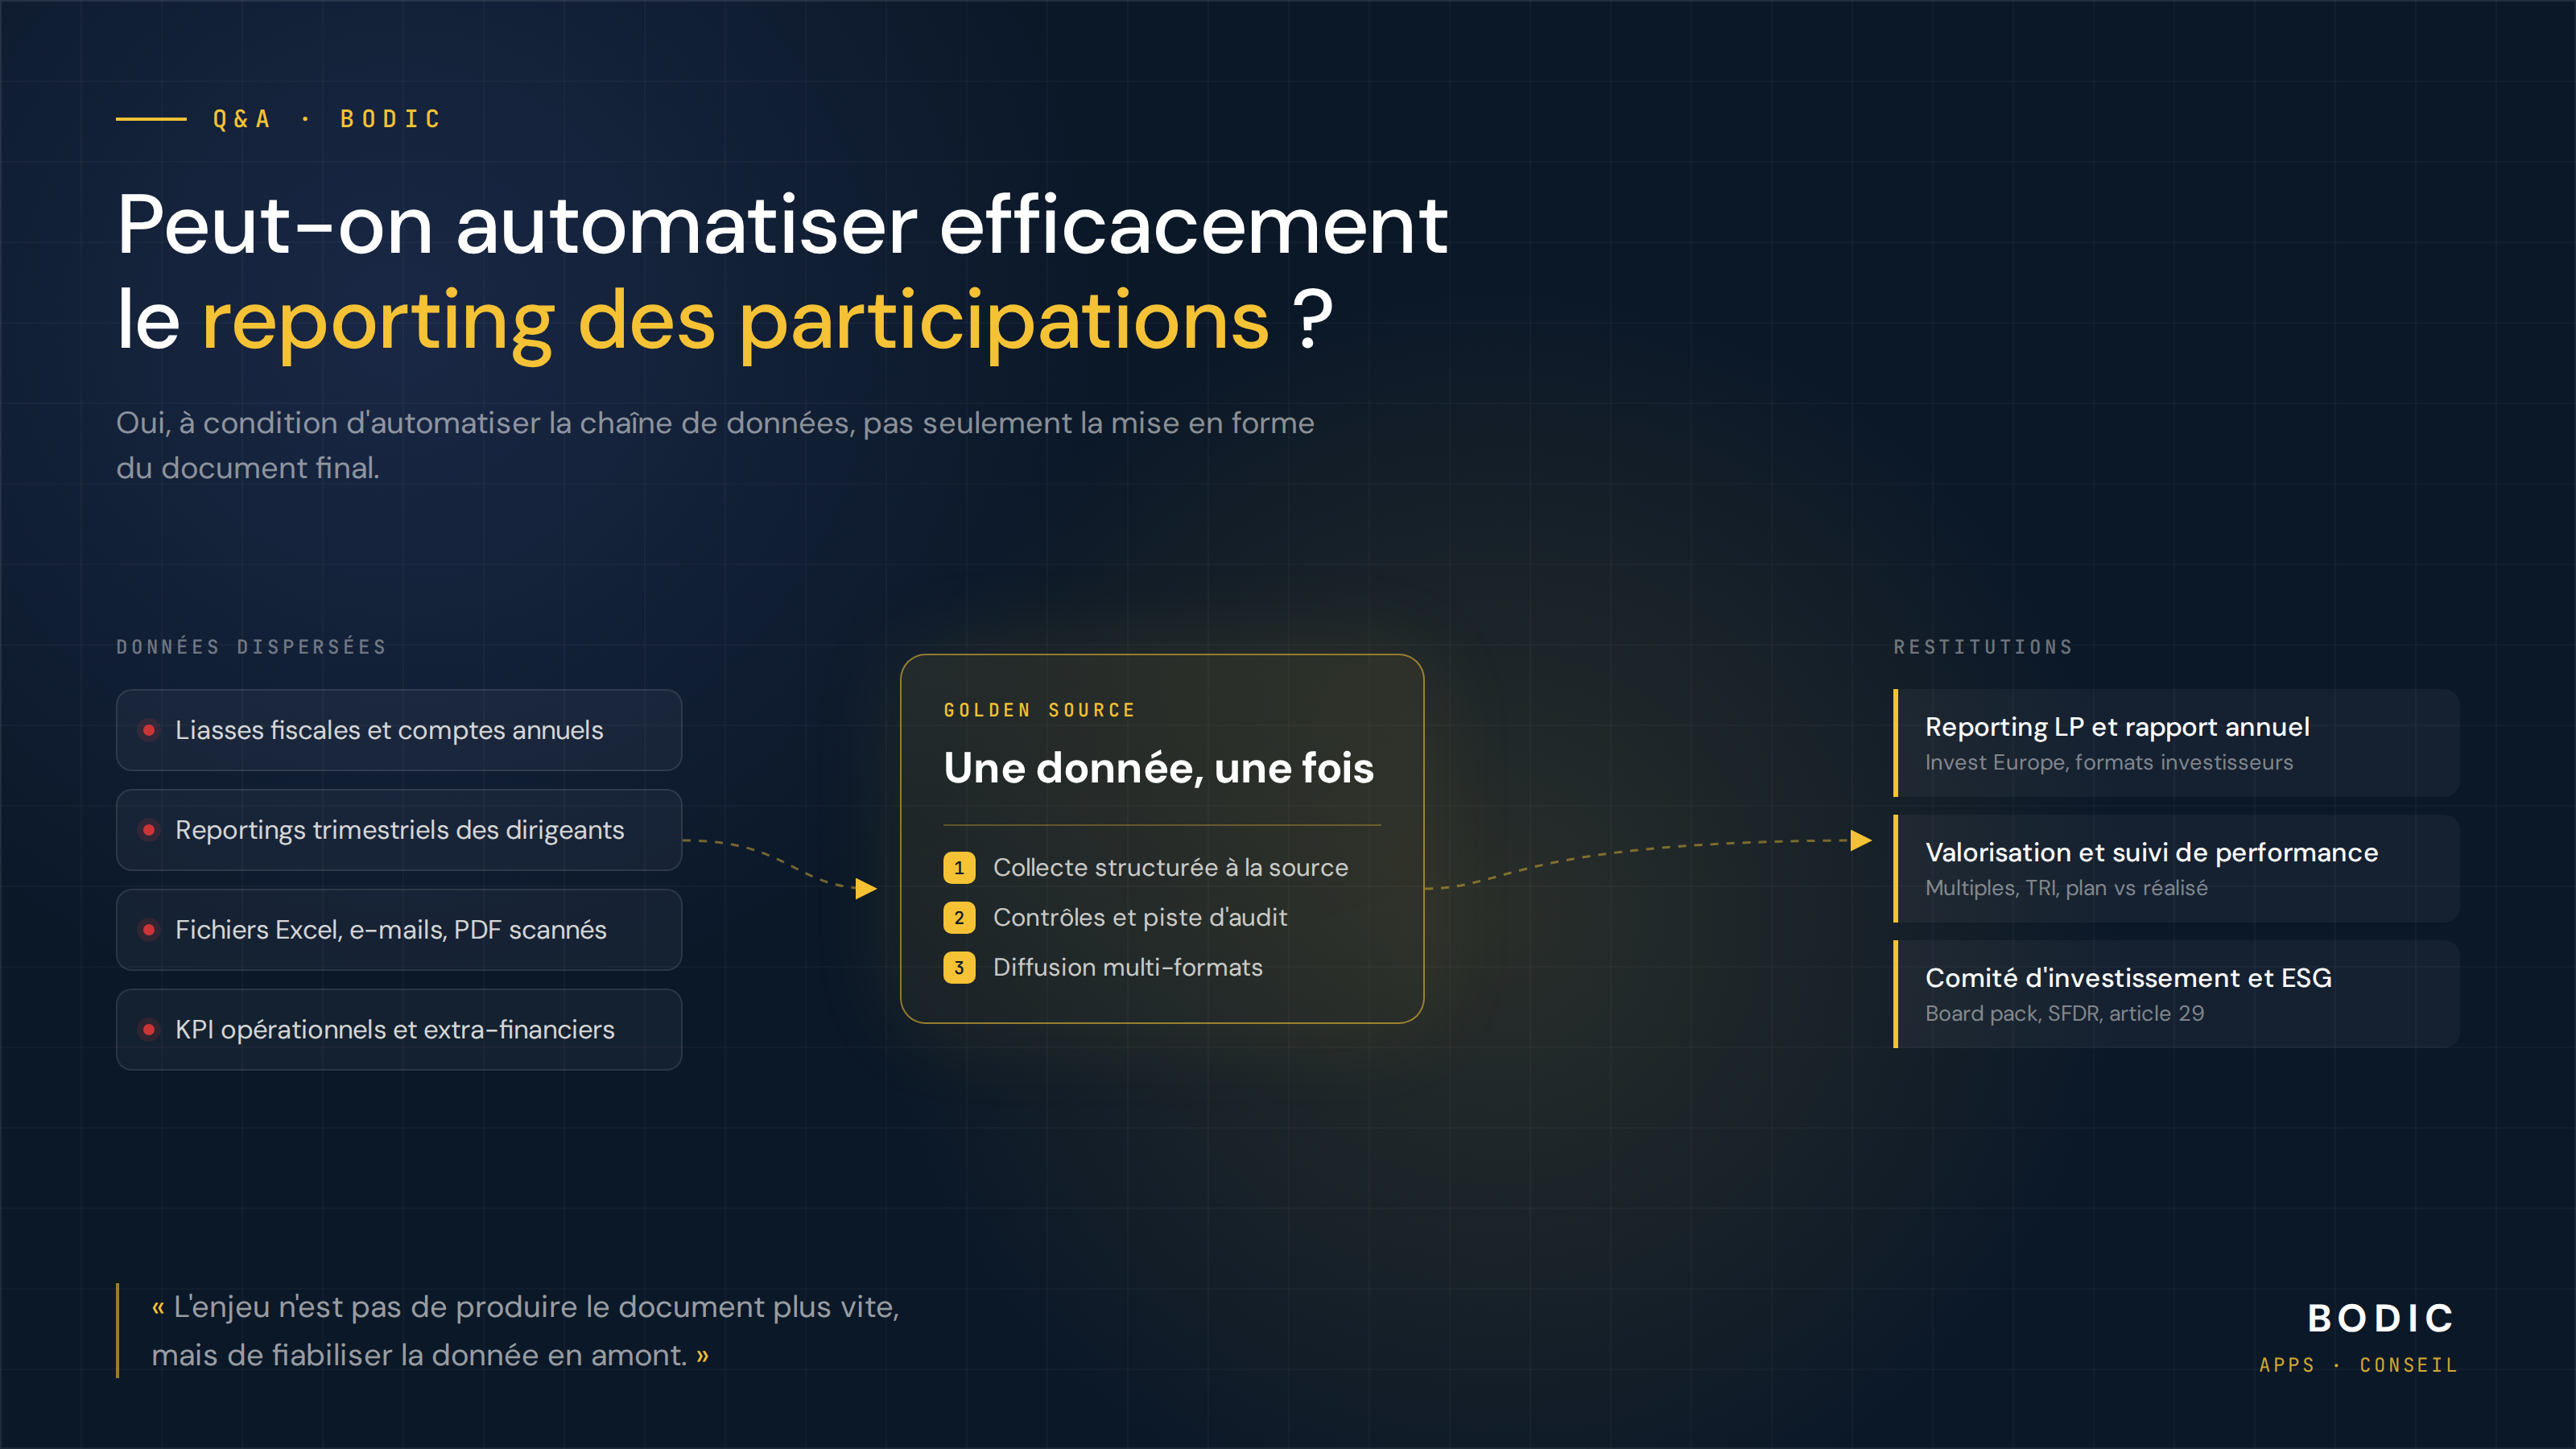
Oui, à condition d'automatiser la chaîne de données, et pas seulement la mise en forme du document final. La plupart des projets échouent parce qu'ils s'attaquent au dernier kilomètre, le rapport LP ou le board pack, alors que le coût réel se situe en amont : collecter, ressaisir et fiabiliser une information produite par des tiers, dans des formats et sur des calendriers différents.
Trois niveaux d'automatisation, par ordre de valeur croissante. La collecte d'abord : un portail de saisie structuré ouvert aux dirigeants des participations remplace la boucle d'e-mails et rend la date de clôture prévisible. C'est le gisement le plus important et le plus sous-estimé. Le contrôle ensuite : cohérence avec le trimestre précédent, écarts au budget, complétude, avec une piste d'audit permettant de répondre à la question « d'où vient ce chiffre ? ». La restitution enfin, qui devient un problème simple une fois la donnée unique, datée et validée.
Reste une frontière à ne pas franchir. Le choix des comparables, le traitement d'un événement exceptionnel et le commentaire adressé aux LP relèvent du jugement du gérant. L'objectif n'est pas de retirer l'humain, mais de le déplacer : moins de temps à fabriquer le chiffre, davantage à l'expliquer.
C'est la logique retenue dans Bodic Apps, où Portfolio Portal, Middle Office et Golden Source partagent la même donnée plutôt que de se la recopier. Le cadrage préalable, référentiel d'indicateurs et conduite du changement auprès des participations, relève de Bodic Conseil.
Par où commencer concrètement avec l'IA dans un fonds ?
La question du point de départ avec l’IA dans un fonds est souvent abordée sous le mauvais angle. Le sujet n’est pas de choisir un outil, mais d’identifier où l’IA peut améliorer concrètement l’efficacité opérationnelle, la qualité des données ou la qualité de décision.
Dans la majorité des sociétés de gestion, les premiers gains ne se situent pas sur des usages complexes ou “spectaculaires”. Ils apparaissent plutôt sur des tâches répétitives, consommatrices de temps et à faible valeur ajoutée intellectuelle : consolidation de reportings, préparation de synthèses, recherche d’informations dans des documents, production de comptes-rendus, structuration de données issues de fichiers hétérogènes ou traitement d’emails récurrents.
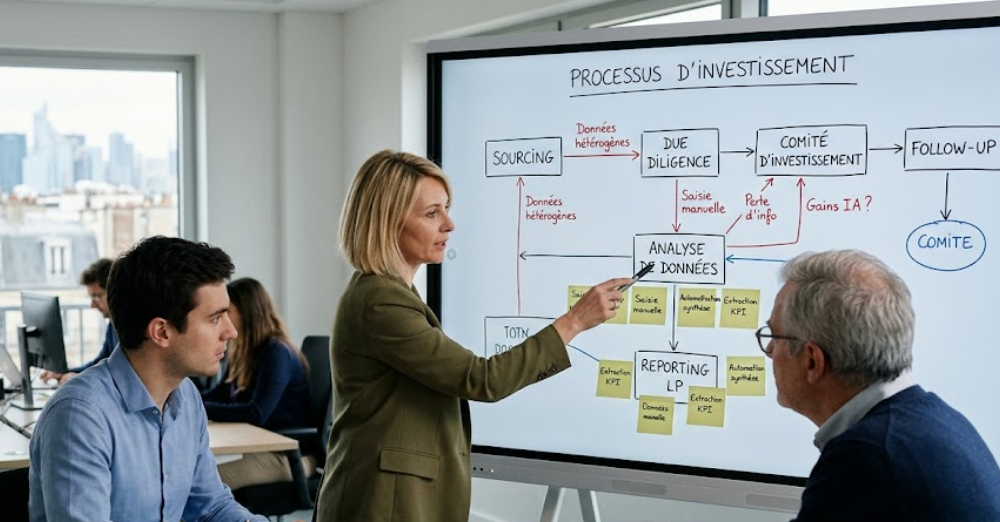
La première étape consiste donc à analyser les processus existants. Il faut comprendre comment les équipes travaillent réellement : où circulent les données, quels outils sont utilisés, où se trouvent les doubles saisies, les retraitements manuels, les pertes d’information ou les dépendances Excel.
Cette phase de cartographie est essentielle, car elle permet d’identifier les zones de friction opérationnelle et les points où l’IA peut apporter un gain immédiat sans modifier profondément les organisations.
La deuxième étape consiste à structurer un minimum la chaîne de donnée. Même une IA performante produit des résultats faibles si elle repose sur des données incohérentes, dispersées ou non gouvernées. Il n’est pas nécessaire de construire immédiatement une architecture complexe, mais il faut disposer d’une base fiable : données centralisées, définitions communes et règles de validation minimales.
Une fois ce socle posé, il devient possible de lancer quelques cas d’usage ciblés, avec trois caractéristiques : un périmètre limité, une valeur mesurable et un risque opérationnel faible.
Les projets les plus efficaces sont souvent très pragmatiques : automatisation de synthèses de mémos, extraction d’informations depuis une data room, préparation de reporting LP, assistance à la recherche documentaire ou structuration de KPI participations.
L’erreur classique consiste à vouloir déployer une stratégie IA globale avant d’avoir stabilisé les fondamentaux data et opérationnels. À l’inverse, les fonds qui avancent efficacement sont ceux qui construisent progressivement : structuration de la donnée, premiers cas d’usage métiers, montée en compétence des équipes, puis industrialisation.
L’IA doit être pensée comme une couche d’accélération au-dessus d’une organisation déjà maîtrisée. Sans fondations solides, elle amplifie les fragilités existantes. Avec une chaîne de donnée structurée et des usages bien cadrés, elle devient un levier opérationnel extrêmement puissant.
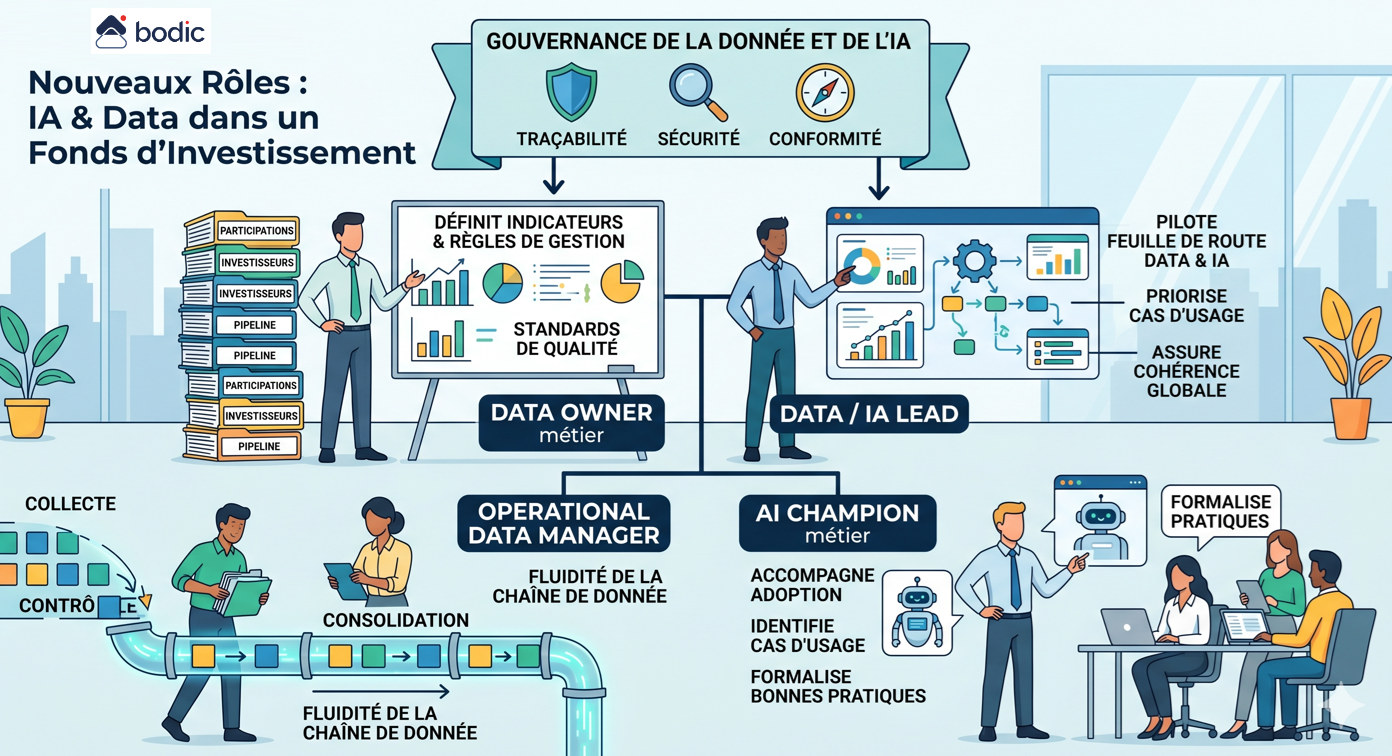
Quels sont les nouveaux rôles à faire émerger dans un fonds avec l'IA et la Data ?
L’introduction de l’IA et de la Data dans un fonds ne crée pas une rupture brutale des métiers, mais fait émerger de nouveaux rôles autour de la structuration de la donnée, de la gouvernance et de l’usage opérationnel.
Le premier rôle clé est celui de Data Owner métier. Il porte la responsabilité d’un périmètre de données critique, par exemple les participations, les investisseurs ou le pipeline. Il définit les indicateurs, les règles de gestion, les formats attendus et les standards de qualité. Sans ce rôle, la donnée reste diffuse et difficilement exploitable.
Le second rôle est celui de Data / IA Lead. Il pilote la feuille de route Data et IA du fonds, priorise les cas d’usage, arbitre les choix d’outils et assure la cohérence globale. Il agit comme un point de convergence entre les équipes d’investissement, le Middle Office, l’IR et les fonctions support.
Un troisième rôle émerge autour de l’Operational Data Manager. Il se situe au cœur des opérations, souvent au Middle Office, et s’assure que les flux de données sont correctement collectés, contrôlés, consolidés et diffusés. Il est responsable de la qualité opérationnelle et de la fluidité de la chaîne de donnée.
Avec l’IA, apparaît également un rôle plus spécifique d’AI Champion métier. Ce profil n’est pas nécessairement technique, mais il maîtrise les outils et leurs usages. Il accompagne les équipes dans l’adoption, identifie les cas d’usage pertinents et formalise les bonnes pratiques, notamment sur la supervision et les limites des agents IA.
Enfin, un rôle transverse de Gouvernance de la donnée et de l’IA devient indispensable. Il couvre les sujets de traçabilité, de sécurité, de conformité et de contrôle. Dans un contexte LP et réglementaire, la capacité à expliquer une donnée ou une décision devient aussi importante que la produire.
Il n’est pas nécessaire de structurer immédiatement une équipe dédiée. Dans la plupart des fonds, ces rôles émergent progressivement à partir des équipes existantes. L’enjeu est d’identifier les responsabilités, de clarifier les périmètres et de structurer une montée en compétence ciblée.
Le point clé reste l’ancrage métier. Ces rôles ne doivent pas être isolés dans une logique purement technique, mais intégrés au cœur des processus d’investissement et de gestion. C’est cette proximité qui permet de transformer la donnée en levier réel de performance.
Nous utilisons des cookies pour vous offrir la meilleure expérience sur notre site. Vous pouvez en savoir plus sur les cookies que nous utilisons ou les désactiver dans les paramètres.