Lässt sich die Berichterstattung über Beteiligungen effizient automatisieren?
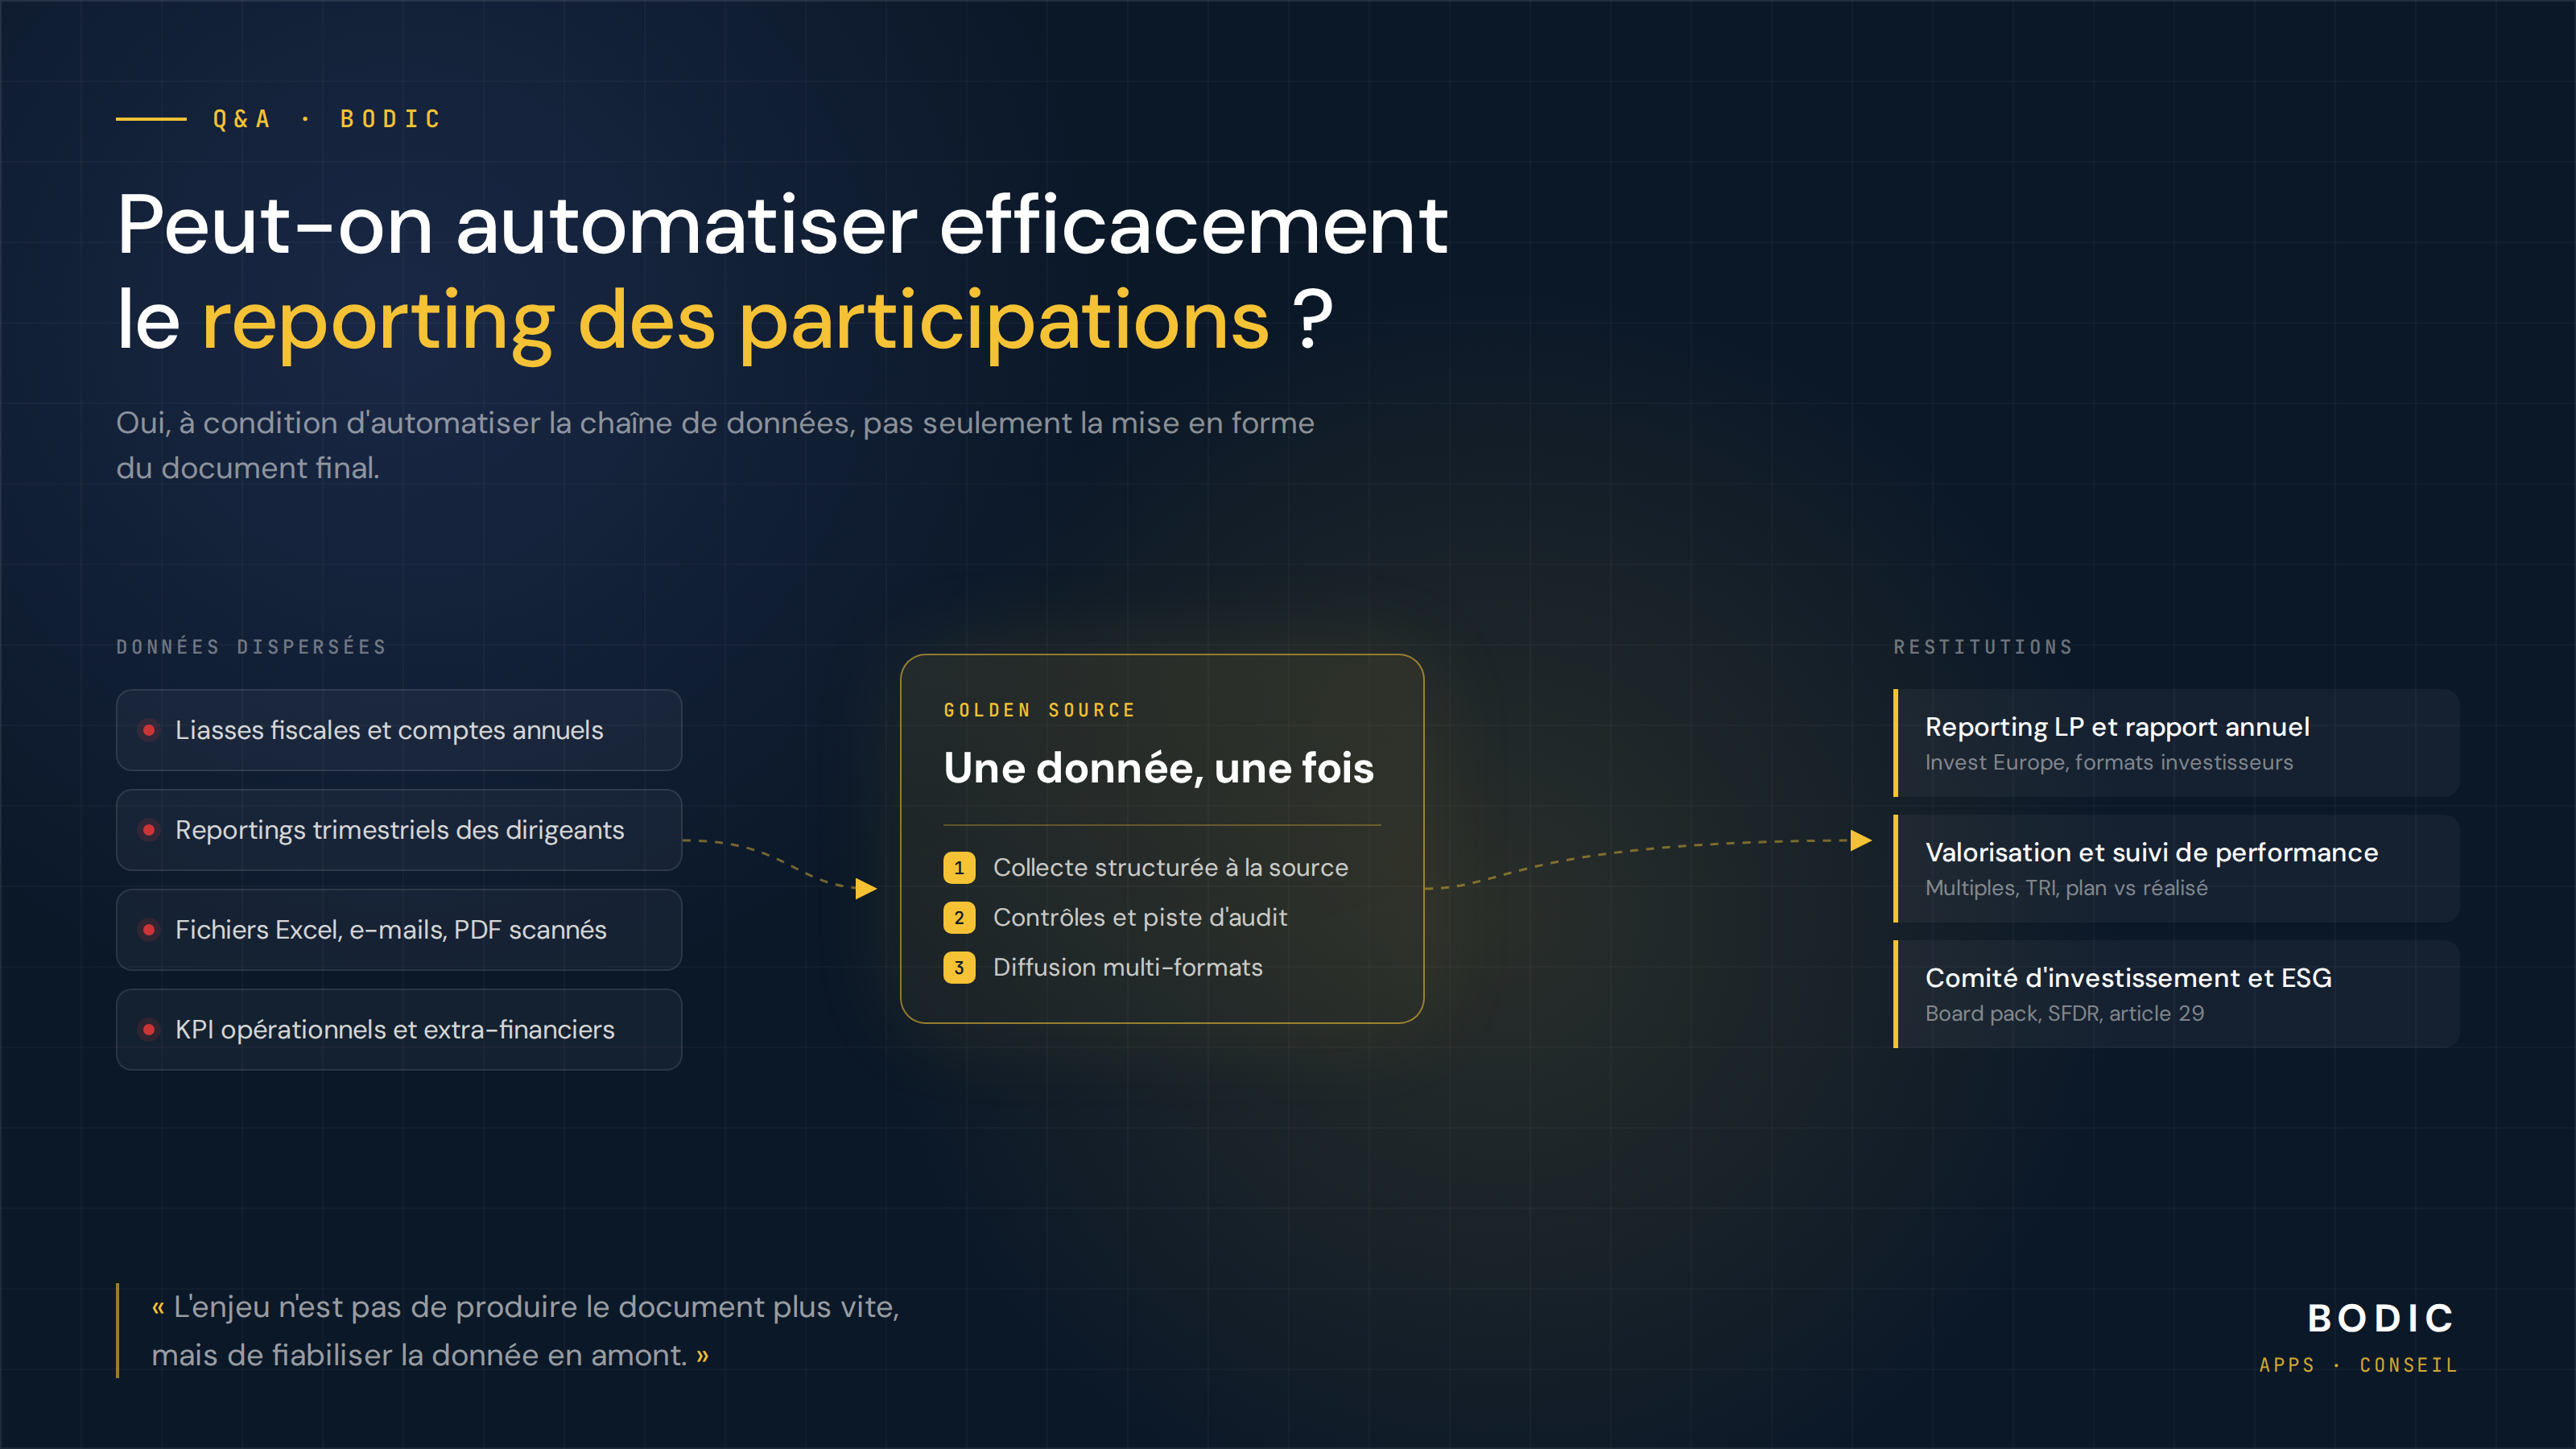
Ja, vorausgesetzt, man automatisiert die gesamte Datenkette und nicht nur die Formatierung des Enddokuments. Die meisten Projekte scheitern, weil sie sich auf die letzte Etappe konzentrieren, nämlich den LP-Bericht oder das Board Pack, während die tatsächlichen Kosten bereits im Vorfeld anfallen: das Sammeln, erneute Erfassen und die Sicherstellung der Zuverlässigkeit von Informationen, die von Dritten in unterschiedlichen Formaten und nach unterschiedlichen Zeitplänen erstellt wurden.
Drei Automatisierungsstufen, in aufsteigender Reihenfolge nach ihrem Wert. Zunächst die Erfassung: Ein strukturiertes Eingabeportal, das den Führungskräften der Beteiligungsgesellschaften offensteht, ersetzt den E-Mail-Kreislauf und macht den Abschlussstichtag vorhersehbar. Dies ist das wichtigste und am meisten unterschätzte Potenzial. Dann die Kontrolle: Übereinstimmung mit dem Vorquartal, Abweichungen vom Budget, Vollständigkeit – mit einem Prüfpfad, der die Frage „Woher stammt diese Zahl?“ beantwortet. Schließlich die Darstellung, die zu einem einfachen Problem wird, sobald die Daten einheitlich, datiert und validiert sind.
Eine Grenze darf jedoch nicht überschritten werden. Die Auswahl der Vergleichswerte, die Behandlung eines außergewöhnlichen Ereignisses und die Erläuterungen für die LP unterliegen dem Ermessen des Fondsmanagers. Das Ziel ist nicht, den Menschen auszuschalten, sondern seine Rolle zu verlagern: weniger Zeit für die Erarbeitung der Zahlen, mehr Zeit für deren Erläuterung.
Das ist die Logik, die bei Bodic Apps zum Tragen kommt, wo Portfolio Portal, Middle Office und Golden Source dieselben Daten nutzen, anstatt sie neu zu erfassen. Die vorangehende Einordnung, das Referenzsystem für Kennzahlen und die Begleitung des Veränderungsprozesses bei den Beteiligungen fallen in den Zuständigkeitsbereich von Bodic Conseil.
Wo soll man mit KI in einem Fonds konkret anfangen?
Die Frage, wo man mit KI in einem Fonds anfangen soll, wird oft aus dem falschen Blickwinkel angegangen. Es geht nicht darum, ein Werkzeug auszuwählen, sondern zu ermitteln, wo KI die betriebliche Effizienz, die Datenqualität oder die Entscheidungsqualität konkret verbessern kann.
In der Mehrzahl der Verwaltungsgesellschaften sind die ersten Gewinne nicht bei komplexen oder "spektakulären" Anwendungen zu verzeichnen. Sie treten vielmehr bei sich wiederholenden, zeitraubenden Aufgaben mit geringem intellektuellen Mehrwert auf: Konsolidierung von Berichten, Erstellung von Zusammenfassungen, Suche nach Informationen in Dokumenten, Erstellung von Berichten, Strukturierung von Daten aus heterogenen Dateien oder Bearbeitung von wiederkehrenden E-Mails.
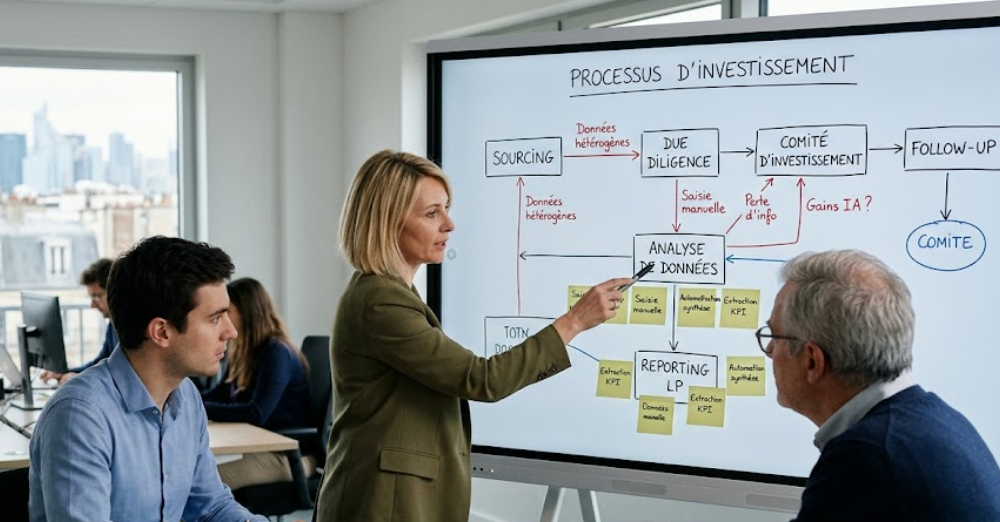
Der erste Schritt besteht also darin, die bestehenden Prozesse zu analysieren. Sie müssen verstehen, wie die Teams tatsächlich arbeiten: Wo zirkulieren die Daten, welche Tools werden verwendet, wo gibt es doppelte Eingaben, manuelle Anpassungen, Informationsverluste oder Excel-Abhängigkeiten.
Diese Kartierungsphase ist entscheidend, denn sie zeigt, wo es betriebliche Reibungspunkte gibt und wo KI unmittelbare Vorteile bringen kann, ohne die Organisationen grundlegend zu verändern.
Der zweite Schritt besteht darin, die Datenkette minimal zu strukturieren. Selbst eine leistungsfähige KI liefert schwache Ergebnisse, wenn sie sich auf inkohärente, verstreute oder nicht regierte Daten stützt. Man muss nicht sofort eine komplexe Architektur aufbauen, aber man braucht eine verlässliche Grundlage: zentralisierte Daten, gemeinsame Definitionen und minimale Validierungsregeln.
Sobald diese Grundlage geschaffen ist, wird es möglich, einige gezielte Anwendungsfälle zu starten, die drei Merkmale aufweisen: begrenzter Umfang, messbarer Wert und geringes operationelles Risiko.
Die effektivsten Projekte sind oft sehr pragmatisch: Automatisierung von Memo-Zusammenfassungen, Extraktion von Informationen aus einem Datenraum, Vorbereitung von LP-Reportings, Unterstützung bei der Literatursuche oder Strukturierung von KPIs für Beteiligungen.
Der klassische Fehler besteht darin, eine globale KI-Strategie zu entwickeln, bevor die Daten- und Betriebsgrundlagen stabilisiert sind. Umgekehrt sind diejenigen Fonds erfolgreich, die schrittweise aufbauen: Strukturierung der Daten, erste geschäftliche Anwendungsfälle, Kompetenzaufbau der Teams und dann Industrialisierung.
Die KI muss als eine Beschleunigungsschicht über einer bereits beherrschten Organisation betrachtet werden. Ohne ein solides Fundament verstärkt sie die bestehenden Schwächen. Mit einer strukturierten Datenkette und einem klaren Rahmen für die Nutzung wird sie zu einem äußerst mächtigen operativen Hebel.
Welche neuen Rollen müssen in einem Fonds mit KI und Data entstehen?
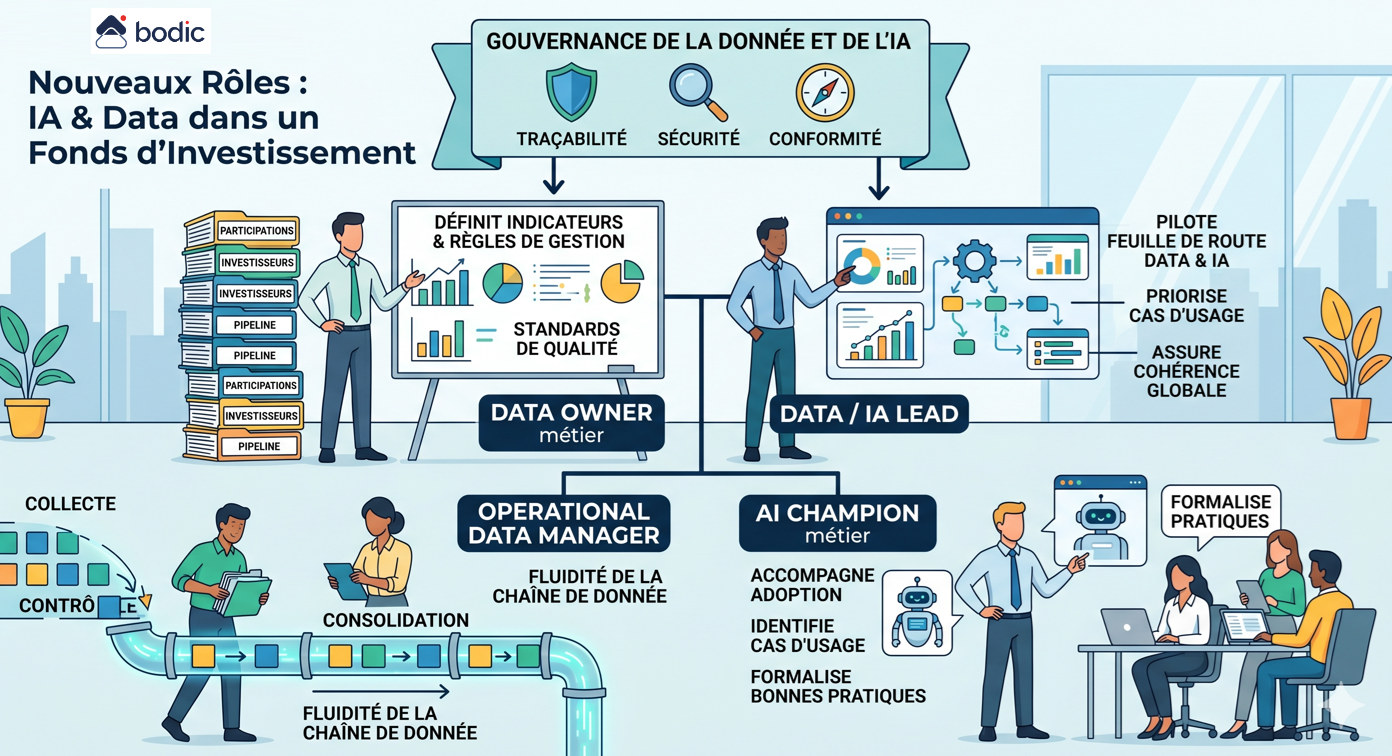
Die Einführung von KI und Data in einem Fonds führt nicht zu einem abrupten Bruch in den Berufen, sondern lässt neue Rollen rund um die Strukturierung der Daten, die Governance und die operative Nutzung entstehen.
Die erste Schlüsselrolle ist die des fachlichen Data Owners. Er trägt die Verantwortung für einen kritischen Datenumfang, z. B. Beteiligungen, Investoren oder die Pipeline. Er definiert die Indikatoren, die Verwaltungsregeln, die erwarteten Formate und die Qualitätsstandards. Ohne diese Rolle bleiben die Daten diffus und schwer verwertbar.
Die zweite Rolle ist die des Data / AI Lead. Er steuert die Data- und AI-Roadmap des Fonds, priorisiert die Anwendungsfälle, entscheidet über die Wahl der Tools und gewährleistet die globale Kohärenz. Er fungiert als Konvergenzpunkt zwischen den Investmentteams, dem Middle Office, der IR und den Unterstützungsfunktionen.
Eine dritte Rolle entsteht rund um den Operational Data Manager. Er befindet sich im Zentrum der Operationen, häufig im Middle Office, und stellt sicher, dass die Datenströme korrekt gesammelt, kontrolliert, konsolidiert und verbreitet werden. Er ist für die operative Qualität und den reibungslosen Ablauf der Datenkette verantwortlich.
Mit der KI entsteht auch eine spezifischere Rolle des KI-Berufschampions. Dieses Profil muss nicht unbedingt technisch sein, aber es beherrscht die Werkzeuge und ihre Nutzung. Es begleitet die Teams bei der Einführung, identifiziert relevante Anwendungsfälle und formalisiert bewährte Verfahren, insbesondere in Bezug auf die Überwachung und die Grenzen von KI-Agenten.
Schließlich wird eine übergreifende Rolle der Daten- und KI-Governance unerlässlich. Sie deckt die Themen Rückverfolgbarkeit, Sicherheit, Einhaltung und Kontrolle ab. In einem LP- und Regulierungskontext wird die Fähigkeit, Daten oder Entscheidungen zu erklären, genauso wichtig wie sie zu produzieren.
Es ist nicht notwendig, sofort ein dediziertes Team zu strukturieren. In den meisten Fonds entstehen diese Rollen allmählich aus den bestehenden Teams. Die Herausforderung besteht darin, die Verantwortlichkeiten zu identifizieren, den Umfang zu klären und einen gezielten Kompetenzaufbau zu strukturieren.
Der Schlüsselpunkt bleibt die fachliche Verankerung. Diese Rollen dürfen nicht in einer rein technischen Logik isoliert werden, sondern müssen in den Kern der Investitions- und Verwaltungsprozesse integriert werden. Es ist diese Nähe, die es ermöglicht, Daten in einen echten Leistungshebel zu verwandeln.
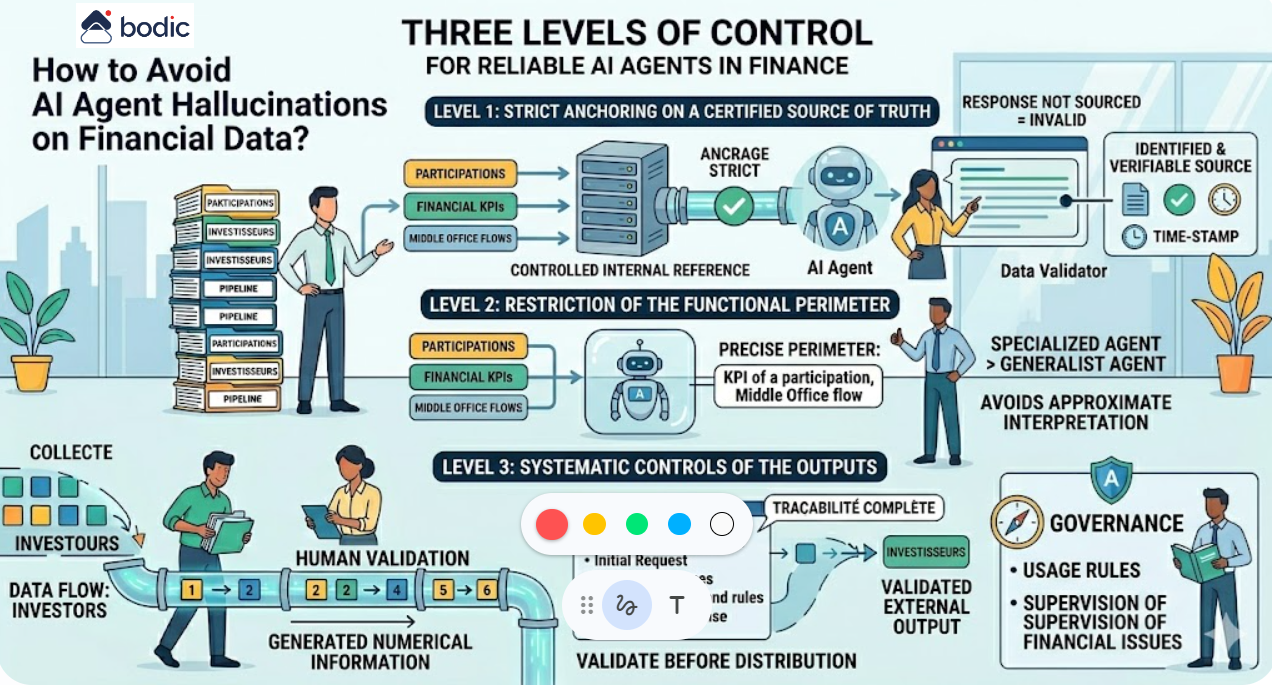
Wie können Halluzinationen eines KI-Agenten bei Finanzdaten verhindert werden?
Halluzinationen sind das größte Risiko beim Einsatz von KI-Agenten im Finanzkontext. Sie sind nicht auf zufällige Fehler zurückzuführen, sondern auf ein strukturelles Verhalten der Modelle, wenn ihnen keine zuverlässigen oder ausreichend eingeschränkten Informationen zur Verfügung stehen.
Dieses Risiko lässt sich durch drei Kontrollebenen stark reduzieren.
Die erste ist die strikte Verankerung an einer zertifizierten Wahrheitsquelle. Der Agent darf sich nicht auf allgemeines Wissen oder implizite Daten stützen, sondern nur auf ein kontrolliertes internes Referenzsystem. Jede Antwort muss mit einer identifizierbaren, zugänglichen und überprüfbaren Quelle verknüpft sein. Eine nicht quellenbasierte Antwort sollte standardmäßig als ungültig betrachtet werden.
Die zweite Ebene ist die Beschränkung des funktionalen und informationellen Umfangs. Ein Agent muss in einem bestimmten Bereich mit einem begrenzten und kontrollierten Datensatz tätig werden. Je breiter der Umfang, desto größer ist das Risiko einer ungefähren Interpretation. In der Praxis ist ein Agent, der auf eine Untermenge von Finanzdaten spezialisiert ist, z. B. die KPIs einer Beteiligung oder die Middle-Office-Feeds, signifikant zuverlässiger als ein generalistischer Agent.
Die dritte Ebene ist die Einführung systematischer Kontrollen der Outputs. Alle Zahleninformationen, die für den externen Gebrauch bestimmt sind, insbesondere für Investoren, müssen einer menschlichen Validierung unterzogen werden. Diese Validierung muss sich auf eine vollständige Rückverfolgbarkeit stützen: ursprüngliche Anfrage, mobilisierte Quellen, angewandte Transformationen und generierte Antwort.
Über diese Grundsätze hinaus spielt die technische Architektur eine entscheidende Rolle. Ein strukturierter Ansatz besteht darin, die KI-Schicht von den Rohdaten zu isolieren, ein zentrales Repository zu verwenden und den Agenten nur validierte Daten zu präsentieren. So lässt sich genau kontrollieren, was der Agent sehen und verwenden kann.
Schließlich ist es wichtig, Halluzinationen als ein Thema der Governance zu behandeln und nicht nur als ein technisches Problem. Das bedeutet, Nutzungsregeln, Verantwortungsebenen und Aufsichtsmechanismen zu definieren, die den finanziellen Herausforderungen angemessen sind.
Ein zuverlässiger Agent ist nicht derjenige, der "gut antwortet", sondern derjenige, bei dem jede Antwort erklärt, zurückverfolgt und verifiziert werden kann.
Wir verwenden Cookies, um Ihnen die beste Erfahrung auf unserer Website zu bieten. Sie können mehr über die von uns verwendeten Cookies erfahren oder sie in den Einstellungen deaktivieren.